El que veu un detector al vídeo de la portada
Josep Castells, , 3 min de lectura
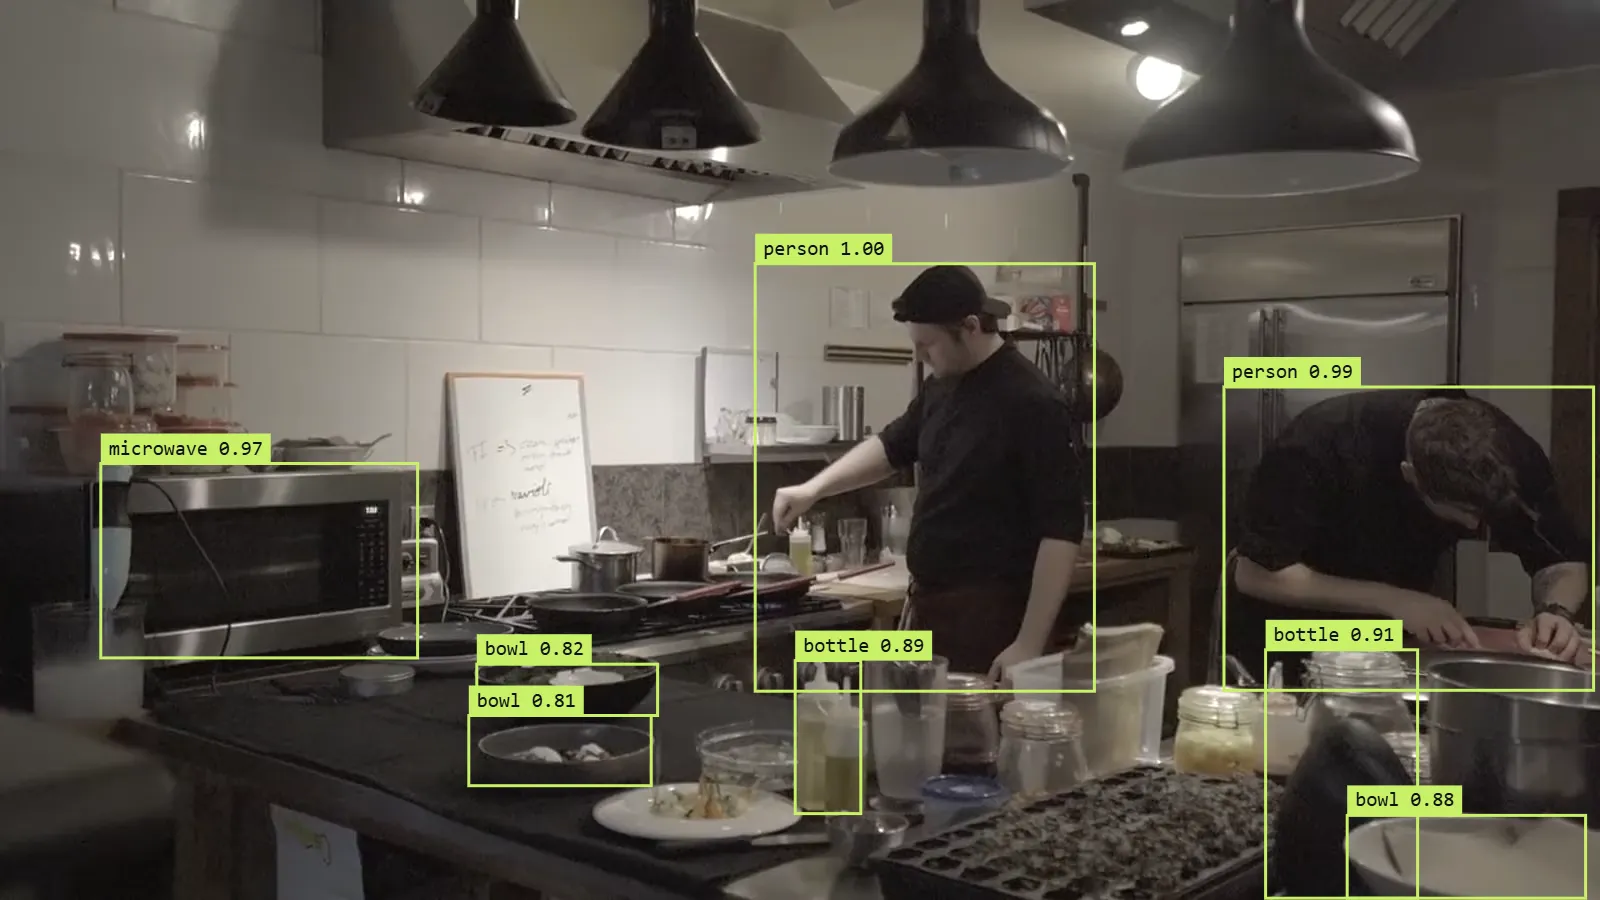
Quina part del vídeo de la portada és un model de veritat, quina està precalculada i quina és un exemple.
El vídeo de la portada no és una animació: sota les capes d'interfície hi ha un model de detecció d'objectes que va analitzar cada pla. Aquí explico com està fet, quina part és real i quina part és un exemple.
Sis plans, dinou segons i mig
El vídeo és un muntatge de sis plans de Pexels, amb talls secs: un encreuament de trànsit, una recol·lectora, un port, una cuina, uns aerogeneradors i una ecocardiografia. Tres d'ells són els sectors dels blocs que apareixen quan fas scroll (camp, cuina i salut); els altres tres donen context. Pexels permet l'ús comercial sense atribució obligatòria, però els clips estan acreditats igualment.
Què fa el detector, i quan
El model és un Faster R-CNN amb MobileNetV3 de torchvision, entrenat amb COCO, que distingeix vuitanta tipus d'objecte. No s'executa al teu navegador: el vaig passar una sola vegada sobre el muntatge, a cinc fotogrames per segon, i vaig desar les caixes en un fitxer de 4 KB que la pàgina dibuixa damunt del vídeo.
A la cuina, per exemple, troba les dues persones amb una confiança d'1,00 i 0,99, el microones, les ampolles i els bols damunt del taulell. Són les caixes de la imatge de dalt, tal com les va retornar el model.
Abans de publicar-les vaig aplicar tres filtres:
- Confiança mínima de 0,7 i com a molt vuit caixes per fotograma, perquè la imatge es llegeixi bé.
- Classes impossibles, fora. Un avió, uns esquís o un plàtan no poden aparèixer en aquests plans; si el model els veu, és un error, i un error a la portada sembla una fallada de la web.
- Cap caixa a l'ecocardiografia. COCO no sap res d'anatomia: en aquell pla l'única cosa que trobava era el teclat. Val més no ensenyar res que ensenyar una cosa irrellevant.
El que el model veu malament
El pla aeri de l'encreuament és el més difícil. COCO està fet de fotos preses a peu de carrer; des d'un dron, un cotxe o una persona tenen una altra forma, i el model dubta. En algun fotograma arriba a marcar com a persona un tros de pati. És un bon recordatori d'una cosa que repeteixo en qualsevol projecte: un model és tan bo com la semblança entre les seves dades d'entrenament i el que li ensenyes després.
El que es calcula al teu navegador
Les corbes de nivell que es mouen sobre la imatge sí que es calculen en directe: la pàgina llegeix la brillantor del vídeo en una graella de 96 per 54 punts i traça quatre nivells amb l'algorisme de marching squares. És barat, no necessita cap model i funciona en qualsevol equip.
Les capes d'interfície que suren al davant (un índex de vegetació al camp, una fracció d'ejecció a salut…) són exemples de com es veuria un sistema així en cada sector, i a la pàgina porten l'etiqueta «Exemple». L'única cosa que surt d'un model de debò són les caixes.
Com se serveix
Un vídeo de sis megues no hauria de frenar una portada:
- Sense reproducció automàtica ni precàrrega. Si tens activat l'estalvi de dades o prefereixes menys moviment, només veus una imatge fixa.
- Dues mides. Al mòbil es descarrega una versió de 1280×720 de menys de 2 MB; el navegador només en baixa una de les dues.
- Fora del repositori. Els vídeos es publiquen a part amb un nom que canvia amb el seu contingut, així que es poden desar a la memòria cau per sempre sense por de servir una versió antiga.
Per què ho explico
Perquè és la mateixa pregunta que cal fer-se davant de qualsevol demo d'IA: quina part és un model, quina part està precalculada i quina part és disseny. Al Laboratori pots provar un detector semblant amb la teva pròpia càmera, i allà tot s'executa en directe.