Dades i models que es poden fer servir en un web comercial
Josep Castells, , 3 min de lectura
Per què el Laboratori no fa servir YOLO ni ImageNet, quines llicències sí que accepta i com es compleix l'atribució de CC BY.
Un model pot ser excel·lent i, tot i així, no poder-se fer servir en una web comercial. Abans de mirar la precisió d'un model per al Laboratori miro dues coses: la llicència del codi i del model, i la de les dades amb què es va entrenar. Aquí hi ha el que vaig descartar, el que vaig acceptar i per què.
El que va quedar fora
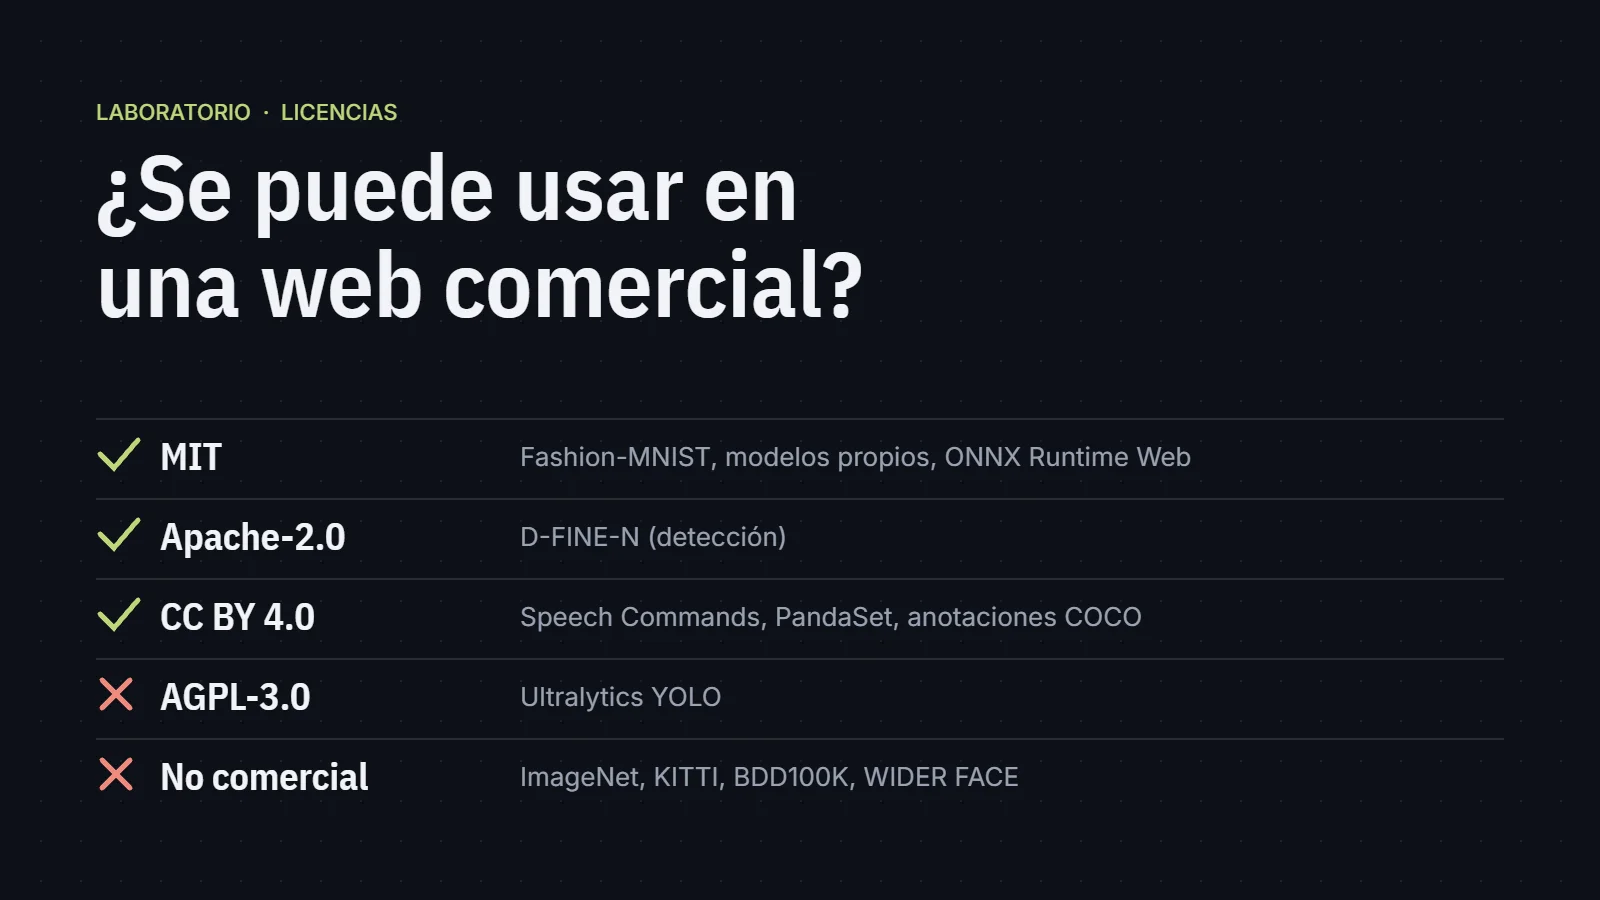
Ultralytics YOLO (AGPL-3.0). És la família de detectors més coneguda i la primera que apareix en qualsevol tutorial. La seva llicència és AGPL: si la fas servir en un servei accessible per xarxa, has de publicar el codi d'aquest servei amb la mateixa llicència. Per a una web comercial això vol dir obrir la web sencera o pagar una llicència comercial. En lloc seu faig servir D-FINE-N, amb llicència Apache 2.0.
Conjunts de dades només per a recerca. ImageNet, KITTI, BDD100K i WIDER FACE són referències en els seus camps, però els seus termes limiten l'ús a finalitats no comercials. Un model entrenat amb aquestes dades arrossega aquest dubte, així que no hi van entrar.
Comprovar el model concret, no la família. Que una arquitectura sigui oberta no diu res del fitxer de pesos que descarregues: cada checkpoint pot tenir la seva pròpia llicència, i alguns es van ajustar amb dades no comercials. Miro el camp de llicència del model exacte que publicaré.
El que sí que es fa servir
- MIT: Fashion-MNIST (© 2017 Zalando SE), els models que he entrenat jo, ONNX Runtime Web i three.js.
- Apache 2.0: D-FINE-N, el detector de la demo de detecció.
- CC BY 4.0: Speech Commands (Pete Warden, Google), les anotacions de COCO i PandaSet, aquest últim amb els seus propis termes a més de la llicència.
- CC BY 4.0 amb clips CC0 o CC BY 3.0: FSDnoisy18k, que només faig servir com a soroll de fons per entrenar el model de veu.
- Anotacions CC BY 4.0, imatges CC BY 2.0: Open Images, per al detector d'ingredients. Deso l'autor i la llicència de cada imatge.
Atribució: el que demana CC BY
CC BY permet l'ús comercial amb una condició: reconèixer l'autoria. Per això el Laboratori té una pàgina de crèdits que es construeix sola a partir de les fitxes dels models: si afegeixo un conjunt de dades, la seva atribució hi apareix sense que me n'hagi de recordar.
Dos matisos que convé saber:
- Les imatges no sempre tenen la llicència de les anotacions. A COCO, les anotacions són CC BY 4.0, però les fotos segueixen els termes de Flickr. S'hi pot entrenar; el que no faig és redistribuir-les.
- Les llicències no anonimitzen. PandaSet no ve anonimitzat. Abans de publicar-ne les imatges vaig desenfocar cares i matrícules, i els seus termes a més prohibeixen fer servir les marques de qui el va publicar.
La regla, en poques paraules
- Llicència del codi i del model: permissiva (MIT, Apache 2.0, BSD). Res de copyleft fort en un servei web.
- Llicència de les dades: que permeti l'ús comercial. «Només recerca» queda fora.
- Cada fitxer concret, no la família ni el nom.
- Atribució automàtica, no de memòria.
- El que no es pugui redistribuir no es redistribueix, encara que s'hi pugui entrenar.
Per què importa fora del Laboratori
La mateixa pregunta apareix en qualsevol projecte d'IA per a una empresa: quin model, amb quines dades i en quines condicions? Un assistent que funciona de meravella en una demo pot no ser utilitzable en producció per una llicència. Ho reviso al principi, al diagnòstic, perquè no aparegui al final.